Observabilité
La Console présente d’abord la situation opérationnelle d’une instance : ce qu’elle exécute, ce qu’elle attend, ce qui nécessite une intervention et les dernières activités enregistrées. La chronologie, le graphe, les données et l’historique permettent ensuite d’examiner les preuves à la bonne profondeur.
Opérations est le point d’entrée
L’onglet Opérations répond aux questions immédiates sans imposer de parcourir le graphe : état global, attentes actives, prochaine reprise connue, warnings, contexte d’exécution et activité récente. Plusieurs branches peuvent être actives en parallèle ; chacune reste visible comme un élément distinct.
Une attente normale — participant, événement, timer, Agent Run, tâche externe ou processus enfant — reste distincte d’un échec. La Console n’invente pas de pourcentage d’avancement lorsque le processus peut brancher ou exécuter plusieurs chemins en parallèle.
La situation opérationnelle conduit vers la chronologie ou le graphe ; l’inspecteur conserve ensuite le contexte de l’élément choisi.
Lorsqu’un test de processus crée une instance réelle, le workspace de test réutilise les mêmes états d’exécution et le même graphe. Le diagnostic de test et l’observabilité opérationnelle parlent ainsi le même langage.
Chronologie et graphe décrivent la même exécution
L’onglet Exécution propose deux représentations complémentaires. La chronologie liste les occurrences d’exécution enregistrées avec leur statut, leurs horodatages, leur durée lorsqu’elle est connue, leurs warnings et leurs erreurs. Le graphe montre les chemins, bifurcations et dépendances du processus.
La sélection est conservée lorsque vous passez d’une représentation à l’autre. Une itération ou une tentative enregistrée peut donc être inspectée précisément sans être confondue avec l’état courant du node.
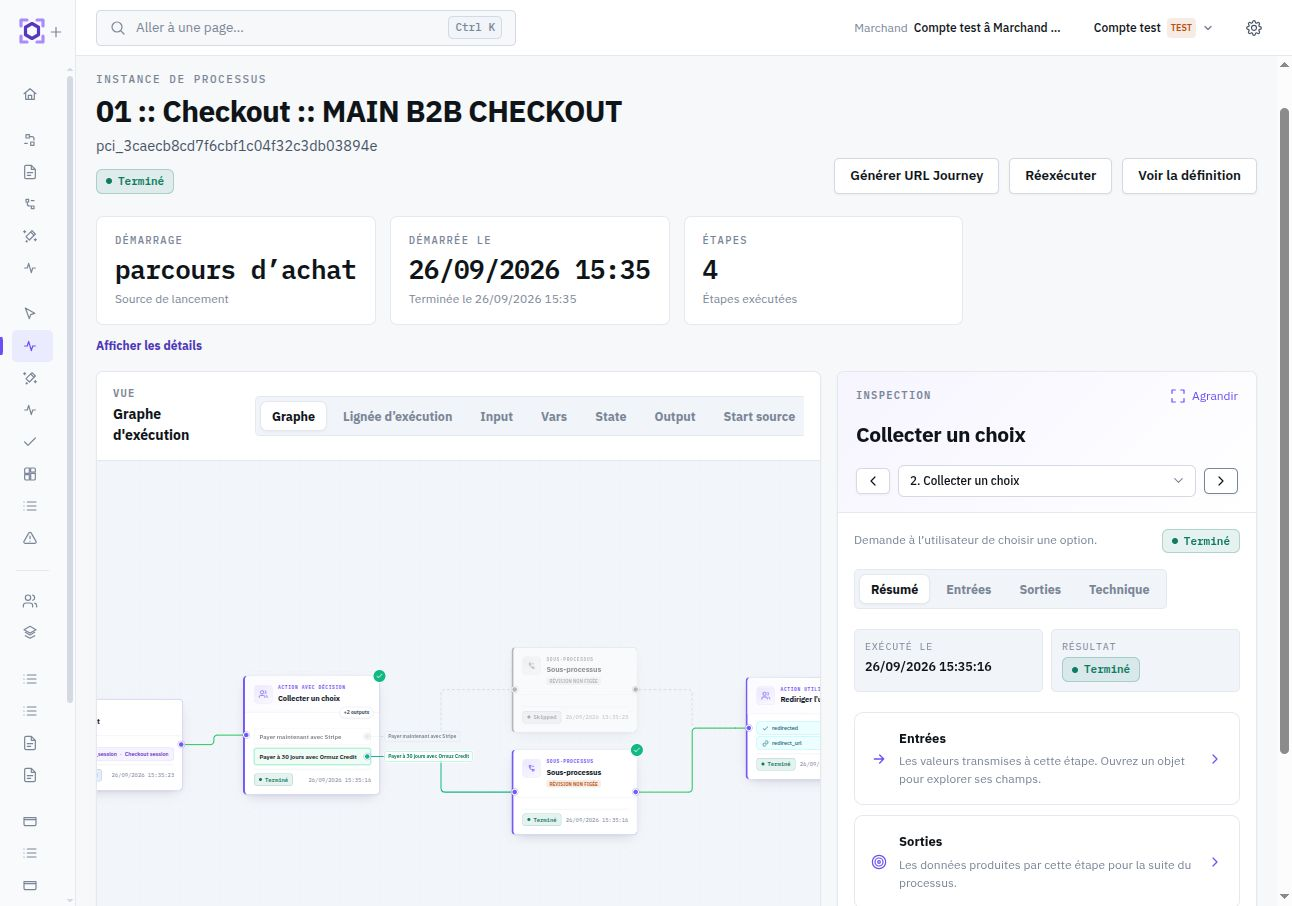
Inspecter un node courant ou une occurrence enregistrée
L’inspecteur est partagé entre la vue Opérations, la chronologie et le graphe. Il expose un résumé, les entrées, les sorties et les informations techniques disponibles, ainsi que les liens vers les détails spécialisés lorsque l’étape délègue son exécution.
Sélectionner une occurrence dans la chronologie affiche les données enregistrées pour cette occurrence. Sélectionner un node dans le graphe affiche son état courant. Cette distinction évite d’attribuer à une ancienne tentative la sortie ou l’erreur d’une tentative plus récente.
| État | Lecture opérationnelle |
|---|---|
running | L’exécution progresse actuellement. |
waiting | Une condition externe, une interaction ou une échéance est attendue. |
completed | L’occurrence a terminé et ses sorties enregistrées sont disponibles. |
failed | L’occurrence n’a pas terminé selon le contrat attendu. |
skipped | Cette occurrence a été ignorée selon le chemin ou la décision applicable. |
Données courantes, interventions et filiation
L’onglet Données présente les valeurs courantes de l’instance : entrée, variables, état, sortie et source de lancement. Les valeurs capturées pour une occurrence historique se consultent depuis l’inspecteur de cette occurrence, afin de ne pas mélanger état courant et état passé.
Historique & contrôle sépare les interventions auditables de la filiation d’exécution. La filiation montre notamment les instances parentes, enfants, retries et forks. L’historique des interventions est soumis aux droits d’audit ; son indisponibilité n’empêche pas de consulter la filiation accessible.
Comprendre l’effet d’une action opérateur
Les actions proposées dépendent de l’état de l’instance et des permissions effectives de l’utilisateur. Elles sont revalidées au moment de l’exécution : si l’instance a changé entre l’affichage et la confirmation, la Console actualise la situation au lieu d’appliquer une action sur un état devenu obsolète.
- Retry crée une nouvelle instance depuis le début avec les mêmes entrées sur la révision Working courante.
- Run again crée également une nouvelle exécution indépendante depuis le début sur la révision Working courante.
- Fork crée une nouvelle instance depuis un point de reprise sélectionné en conservant la révision exécutée par l’instance source ; les descendants du point de reprise peuvent être rejoués.
- Stop demande l’arrêt de l’instance ; aucune nouvelle étape ne démarre une fois l’arrêt effectif.
Une nouvelle exécution ou un fork peut réexécuter des étapes ayant des effets externes. Vérifiez le point de reprise et les garanties d’idempotence avant de confirmer l’action.
Runs enfants et frontières d’exécution
Certains nodes ouvrent une exécution spécialisée. Un Agent task crée un Agent Run, un subworkflow ouvre une instance enfant et une External Task crée une occurrence de travail délégué avec son propre historique de tentatives. La vue du processus conserve un résumé et permet de descendre vers le détail spécialisé lorsque l’investigation le nécessite.
Cette hiérarchie évite de recopier toute l’exécution enfant dans le parent. L’instance indique ce qui est nécessaire pour comprendre l’orchestration ; la vue spécialisée conserve le détail de sa propre frontière d’exécution.
Warnings : réussir avec un diagnostic
Un warning représente une condition observable qui mérite l’attention sans rendre automatiquement l’exécution invalide. Il est rattaché à l’exécution qui l’a produit, ce qui permet de distinguer un succès nominal d’un succès accompagné d’une anomalie ou d’un mécanisme de repli.
Un node ou un Run peut terminer avec succès tout en portant un warning. Une erreur, elle, empêche l’exécution de satisfaire son contrat et conduit au traitement d’échec ou de retry applicable.
Les warnings suivent les frontières d’exécution de manière contrôlée. Les warnings produits par les tools d’un Agent sont visibles dans l’Agent Run et peuvent être synthétisés sur le node parent. Pour un sous-processus ou un foreach, le parent peut remonter un résumé afin d’orienter l’investigation vers l’exécution concernée.
Données protégées et reveal ciblé
Les inputs, outputs et contextes restent soumis aux classifications sensitive et secret. Les valeurs concernées sont masquées dans les vues générales ; leur présence reste visible afin de conserver un diagnostic utile.
Lorsqu’une valeur persistante précise doit être consultée, la Console propose un reveal ciblé soumis aux droits et au motif requis. La valeur est présentée temporairement dans une fenêtre dédiée. Une occurrence historique ne devient pas pour autant une archive en clair : le reveal reste borné aux valeurs que la plateforme peut autoriser et tracer.
Voir Révélation contrôlée pour le contrat complet.
Diagnostiquer un échec
Commencez par la situation opérationnelle puis ouvrez l’occurrence concernée. Cette progression évite de déduire la cause depuis le seul statut global et conserve les données de la tentative réellement examinée.
- Identifiez l’échec ou l’attente active dans Opérations.
- Ouvrez l’occurrence dans la chronologie ou localisez le node dans le graphe.
- Vérifiez ses entrées, sorties, erreur et warnings enregistrés.
- Ouvrez l’Agent Run, l’instance enfant ou l’External Task lorsqu’un diagnostic plus profond est disponible.
- Utilisez un reveal uniquement pour la valeur protégée réellement nécessaire à l’investigation.
La manière dont Ormuz reprend une exécution et évite de répéter des effets est documentée dans Erreurs, retries et idempotence.